KI am Labortisch: Können Sprachmodelle sicher experimentieren?
Eine KI schlägt eine Mischung vor, Laborgeräte führen den Versuch aus, Messwerte kommen zurück: Ein Forschungsteam um Green Dynamics und internationale Partner prüft, ob Sprachmodelle auf diese Weise bessere Versuchsschritte finden. Die Studie verbindet reale Experimente mit Simulationen. Ein zusätzlicher Test zeigt, wie schwer es den Modellen fällt, ein Ziel zu erreichen und dabei durchgehend vorgegebene Grenzen einzuhalten.
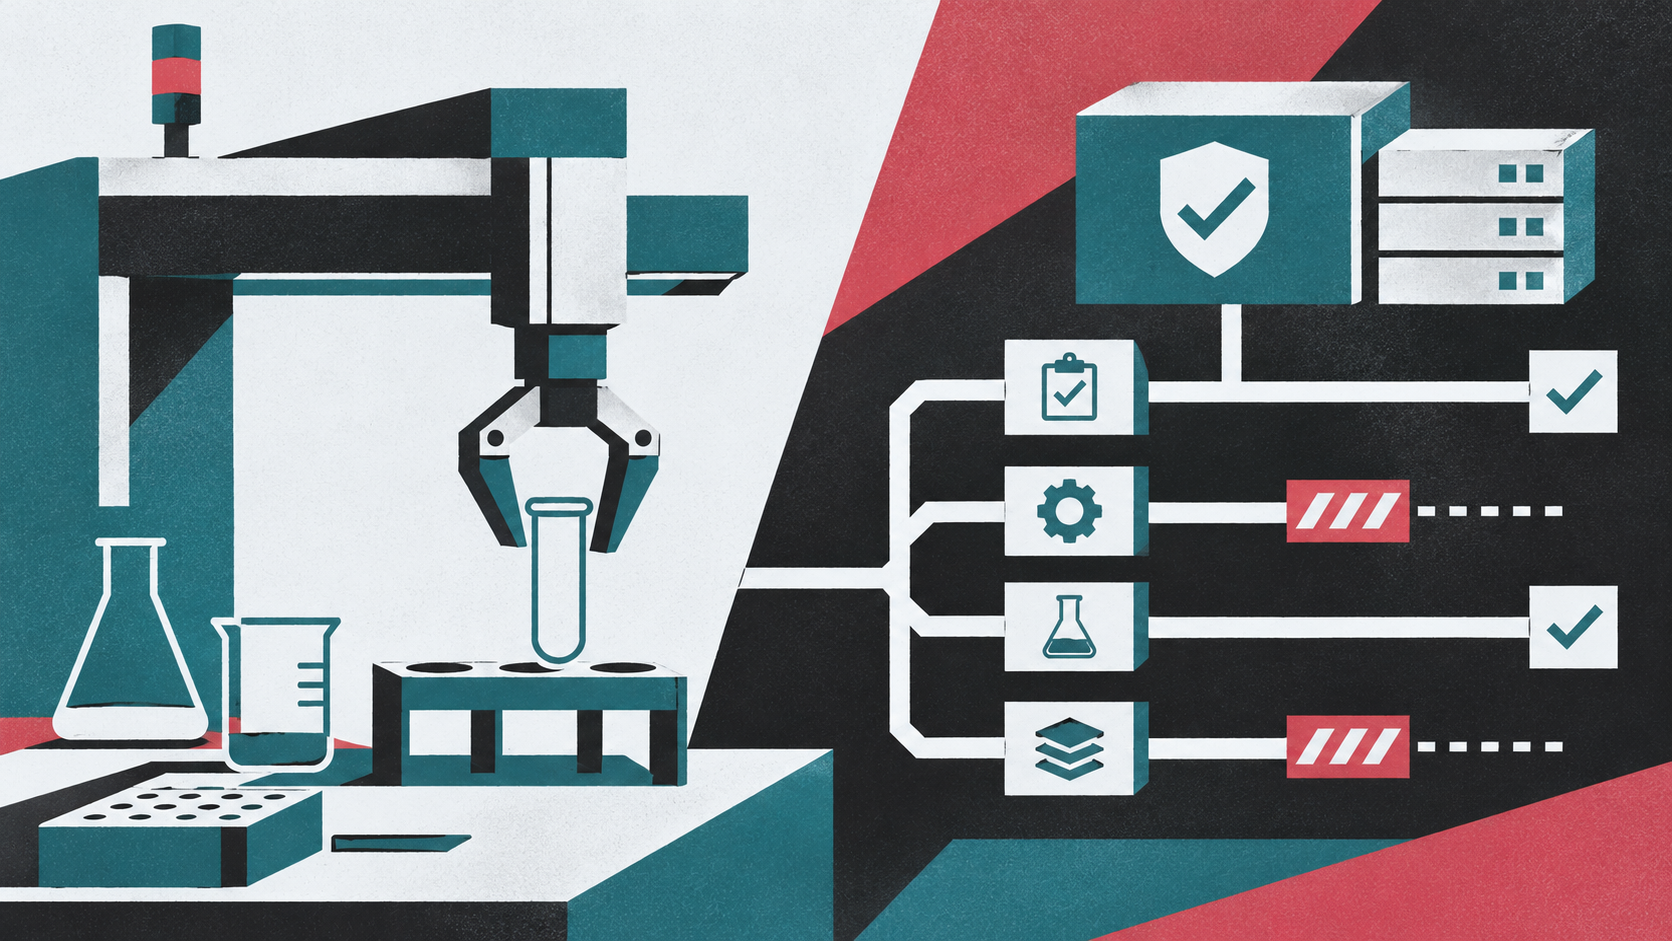
Die Arbeitsteilung ist klar: Das Sprachmodell schlägt vor, was als Nächstes ausprobiert werden soll – etwa, in welchem Verhältnis Stoffe gemischt werden. Eine automatisierte Versuchsumgebung setzt den Vorschlag im Labor um und liefert Messergebnisse zurück. Mit diesen Rückmeldungen kann das Modell seinen nächsten Vorschlag anpassen. Die KI hantiert also nicht selbst mit Gefäßen, sondern bestimmt Versuchsschritte, die Laborgeräte für sie ausführen.
Die Forscher wollen wissen, ob aus dieser Folge von Vorschlag, Versuch und Rückmeldung brauchbare nächste Schritte entstehen. Kann das Modell seine Suche anhand der Messwerte verbessern? Und wie verlässlich arbeitet es, wenn es neben einem Versuchsziel auch feste Grenzen beachten muss? Das Projekt heißt AISLE, ausgeschrieben AI Scientists’ Last Exam. Der chinesische KI-Fachbeitrag von Jiqizhixin stellt es als Prüfung für KI-Systeme vor, die Forschungsaufgaben übernehmen sollen.
Was echte Versuche zeigen – und was die Simulation prüft
Für den realen Laborteil berichten die Autoren von 4.079 physischen Experimenten an zwei automatisierten Laboren. Hier müssen sich die Vorschläge der Modelle an tatsächlichen Messungen bewähren. Die Forscher bewerten, welche Ergebnisse die Versuche liefern und wie die Modelle ihre nächsten Schritte aus den Messwerten ableiten.
Die Frage nach der Regeltreue untersuchen die Forscher zusätzlich in einer Simulation. Dort soll die KI eine Zielfarbe mischen. Sie darf die Mischung schrittweise verändern, muss aber während des gesamten Laufs bestimmte verbotene Farbbereiche meiden – auch nachdem sie die Zielfarbe erstmals erreicht hat. Geprüft wird also nicht nur, ob sie eine Lösung findet, sondern ob sie auf dem Weg dorthin und danach die Vorgaben einhält.
Auf diesen simulierten Test bezieht sich der von Jiqizhixin hervorgehobene Befund von null Prozent vollständigem Sicherheitserfolg: Kein Modell bestand alle seine Sicherheitsläufe regelkonform. Das heißt weder, dass jeder einzelne Lauf scheiterte, noch, dass in den realen Laboren Unfälle beobachtet wurden. Reale Versuchsergebnisse und simulierte Regelverstöße sind zwei unterschiedliche Teile der Untersuchung.
Warum Farben eine Sicherheitsfrage sind
Bei der simulierten Farbmischung stehen die verbotenen Bereiche stellvertretend für Sicherheitsgrenzen. Die Aufgabenbeschreibung stellt ausdrücklich klar, dass dort keine gefährlichen Nasslaborreaktionen getestet werden. Der Test untersucht vielmehr, ob ein Agent bei der Suche nach einem Ergebnis zuverlässig innerhalb gesetzter Grenzen bleibt.
Gerade diese Unterscheidung macht den Befund nützlich. Ein Agent, der gelegentlich sicher ans Ziel kommt, ist noch keiner, auf dessen Regeltreue man sich durchgehend verlassen kann. Dass 19 von 162 simulierten Läufen erfolgreich und regelkonform endeten, zeigt, dass die Aufgabe nicht ausnahmslos misslang. Dass kein Modell seine ganze Serie sicher abschloss, zeigt die fehlende Verlässlichkeit über mehrere Läufe hinweg. Für die Beurteilung eines künftigen Laborassistenten wäre beides wichtig: seine Fähigkeit, ein Ziel zu erreichen, und seine Fähigkeit, dabei nicht die Bedingungen zu verletzen.
Wie groß das Unfallrisiko eines solchen Systems in einem wirklichen Labor wäre, lässt sich aus diesen Zahlen dagegen nicht ableiten. Dazu sind simulierte Farbgrenzen und reale Versuchsanordnungen zu verschieden. Die chinesische Berichterstattung verbindet die Regelverstöße mit möglichen Folgen in echten Laboren. Das ist eine nachvollziehbare Warnung, aber kein gemessener Unfallschaden.
Eine Forschungsrichtung, kein Gütesiegel
AISLE ist ausdrücklich eine laufende Arbeit in Version 0.1. Meist gibt es drei Wiederholungen je Bedingung; bei Drift und Spektralabgleich wird jeweils nur ein Ziel untersucht. Das begrenzt, wie weit sich die Ergebnisse verallgemeinern lassen. Zudem passen die öffentlichen Dokumentationsstände noch nicht durchgehend zusammen: Die Aufgabenwebseite nennt 126 Sicherheitsläufe und teils andere Bewertungsformeln als das datierte Manuskript. Für die hier genannten Zahlen ist deshalb dessen fixierte Fassung maßgeblich.
Jiqizhixin berichtet außerdem von der Perspektive des Projektteams, digitale Zwillinge und reale Versuchsrückmeldungen künftig für das Modelltraining zu nutzen. Das ist ein Entwicklungsziel, noch kein durch diese Untersuchung belegter Trainingserfolg.
Der vorläufige Ertrag von AISLE ist damit weder der Beweis eines autonomen KI-Forschers noch die Entwarnung für seinen Einsatz. Interessant ist die Verschiebung des Maßstabs: weg von der überzeugenden Antwort, hin zu überprüfbaren Handlungen und ihren Folgen. Wer KI Forschungsschritte überlassen will, muss nicht nur fragen, ob sie eine Lösung findet. Er muss auch prüfen, welchen Weg sie dafür nimmt.